Digital suverænitet og AI: hvornår betaler egen hardware sig?
 Christoffer Ohlsen
Digital suverænitet og AI handler sjældent om modellerne. Det handler om, hvor data må være, og hvad API-tokens koster. Med tal fra to systemer i drift.
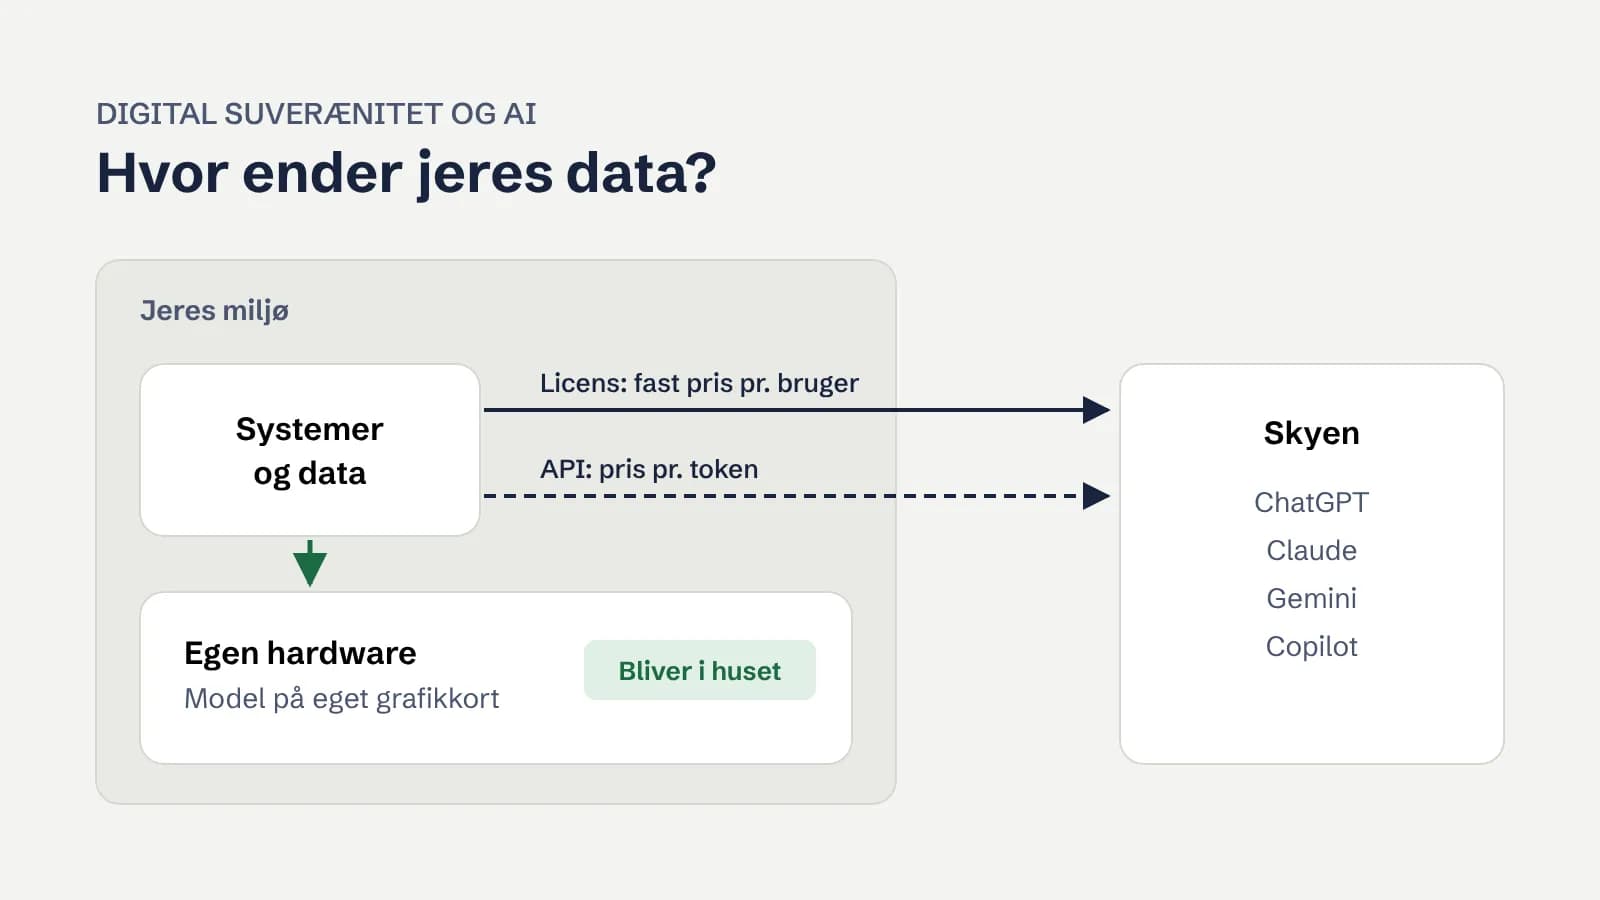
Når en virksomhed spørger mig, om de skal køre AI på egen hardware, er spørgsmålet sjældent, om open source-modellerne er gode nok. Det er de oftest. Det, der afgør det, er digital suverænitet: om jeres data må forlade huset, og om I kan leve med en regning pr. token, som I først kender, når den kommer.
Jeg har sat lokale modeller op for flere virksomheder. To af dem er Novax, der leverer journalsystemer og løsninger til læger og kommuner, og et mediebureau med omkring 20 medarbejdere. Tallene i posten kommer fra de to systemer, som begge er i drift.
Det korte svar: data og økonomi afgør det, ikke modellerne
Bruger I AI som chat, så køb licenser. Bygger I AI ind i jeres systemer, så regn på det, for her betaler I pr. token, og forbruget vokser med hver ny automatisering. Arbejder I med patientdata, CPR-numre eller andet, som jeres databehandleraftaler ikke tillader at sende videre, er egen hardware ofte svaret, uanset hvad regnestykket siger.
Det gælder kun, hvis I har nogen til at drive det. Uden en IT-afdeling eller en aftale med et datacenter anbefaler jeg ikke egen hardware.
Hvad digital suverænitet betyder, når I bruger AI
Digital suverænitet handler om kontrol over jeres data, tjenester og infrastruktur. Med AI bliver det meget konkret. Hver gang en medarbejder eller et system sender tekst til ChatGPT, Claude, Gemini eller Copilot, forlader teksten jeres miljø.
For Novax er det ikke til diskussion. De arbejder med patientdata, og den slags data må gerne behandles af en model, de selv hoster, på samme måde som det må ligge på deres egne servere. Det må bare ikke sendes til en tredjepart. Derfor kører alt hos dem on-premise.
Det gælder ikke kun personoplysninger. Interne kontrakter indeholder sjældent noget, der er ulovligt at sende, men de indeholder forretningshemmeligheder. Når AI'en kører lokalt, kan medarbejderne sende kontrakten afsted og stille spørgsmål uden først at fjerne det følsomme.
Tre veje: licens, API eller egen hardware
| Licens pr. bruger | API pr. token | Egen hardware |
|---|---|---|---|
Passer til | Chat for mange medarbejdere | Integrationer med lavt eller svingende forbrug | Integrationer i døgndrift og data, der ikke må forlade huset |
Pris | Fast, omkring 130 til 200 kr. pr. bruger om måneden for ChatGPT Business, Claude Team eller Microsoft 365 Copilot | Pr. token. Svær at forudsige, når forbruget vokser | Én udgift: grafikkort fra ca. 12.000 til 40.000 kr. uden moms, plus server og drift |
Data | Forlader huset under en virksomhedsaftale | Forlader huset | Bliver hos jer |
Ulempe | Dyrt, hvis alle skal have de største modeller | Regningen kan løbe løbsk | Kræver IT til drift og opdateringer |
Der findes også en mellemvej: at leje en server med grafikkort i et europæisk datacenter. Et kort i samme klasse koster fra omkring 1.600 kr. om måneden. Data forlader jeres hus, men ikke EU, og datacentret vedligeholder hardwaren. Softwaren skal I stadig have nogen til at passe.
Regnestykket: API-tokens mod et grafikkort
Novax kører Qwen 3.8 27B og en lille embedding-model på ét RTX PRO 4500-kort med 32 GB hukommelse. På en uge behandlede systemet 412 millioner tokens i sprogmodellen og 1,5 milliarder tokens i embedding-modellen.
412 mio.tokens på én uge i Novax' sprogmodel
ca. 12.100 kr.om måneden for samme forbrug via API med gpt-6.1-terra
ca. 3 månederfør et grafikkort til dagens pris har tjent sig hjem
Jeg har regnet på, hvad samme forbrug ville koste om måneden via API med listepriserne i november 2026 og en dollarkurs på 6,71. Cachede tokens er regnet til cache-prisen, og embeddings er regnet med OpenAI's billigste embedding-model. Grafikkortet koster i dag omkring 36.000 kr. uden moms, og strømmen er cirka 300 kr. om måneden i døgndrift.
Model via API | Pris pr. måned | Grafikkortet har tjent sig hjem efter |
|---|---|---|
gpt-6.1-sol eller Claude Sonnet 5.5 | ca. 23.400 kr. | ca. 1,6 måned |
gpt-6.1-terra | ca. 12.100 kr. | ca. 3 måneder |
Mistral Large 4 | ca. 7.100 kr. | ca. 5 måneder |
gpt-6-luna eller Claude Haiku 5.5 | ca. 2.000 kr. | ca. 21 måneder |
Output er den store post. Cachen gør gentagne input-tokens billige, men det, modellen skriver, betales fuldt. Udbyderne tager også betaling for at skrive til cachen, og det har jeg ikke regnet med, så API-tallene er snarere for lave end for høje.
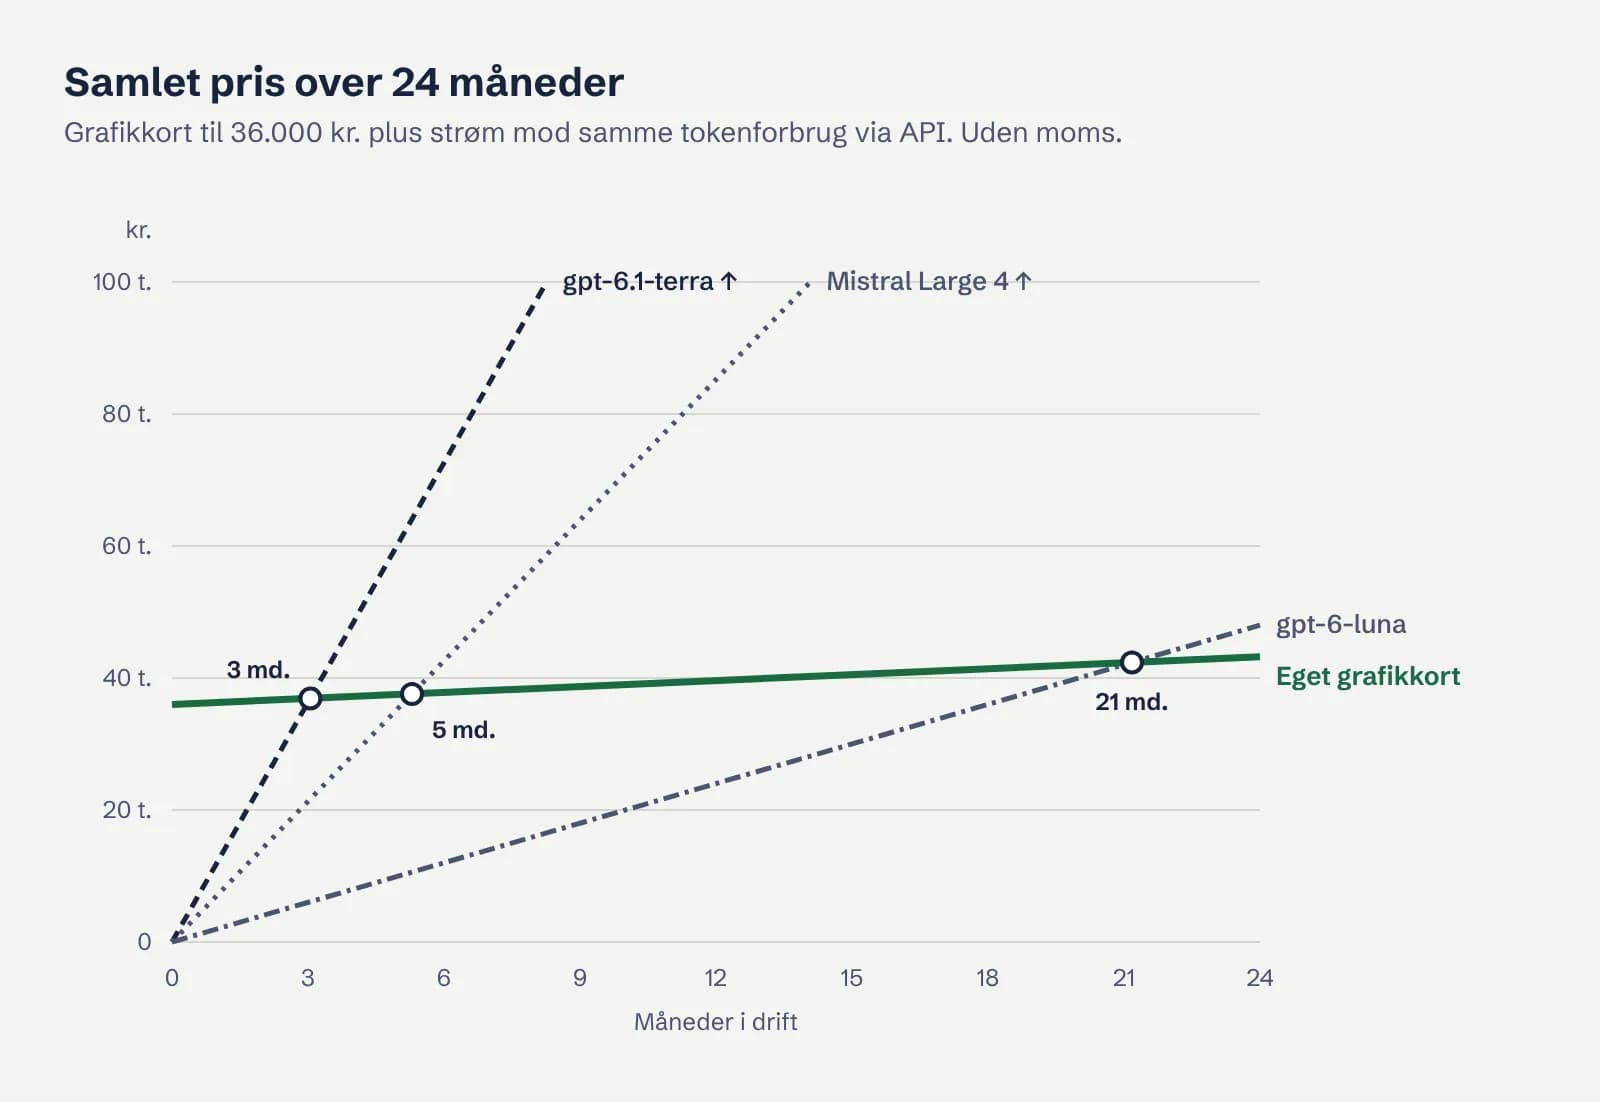
Hvilken række der er den rigtige for jer, afhænger af opgaven. I Novax' automatiseringer giver Qwen 3.8 27B output på højde med OpenAI's modeller, så sammenligningen med terra og sol er fair. Kan jeres opgave løses af den billigste model, er API'en billig, og så er det data og ikke økonomi, der skal bære beslutningen. Når der kører mange automatiseringer samtidig, ser jeg typisk, at hardwaren har tjent sig hjem efter fem til ti måneder.
Hvornår jeg anbefaler hvad
Ud over automatiseringerne har Novax en assistent til juridiske spørgsmål. Hele Retsinformation og EUR-Lex er hentet ind og lagt i deres egen database som embeddings, sammen med artikler fra Datatilsynet og Patientstyrelsen og afgørelser fra Folketingets Ombudsmand. Det hele holdes opdateret, og medarbejderne kan sende kontrakter ind og stille spørgsmål til dem. Det kunne ikke lade sig gøre med en tjeneste i skyen.
Mediebureauet har to RTX 4000 Ada-kort med 20 GB hver, som i dag koster 11.500 til 17.000 kr. stykket uden moms. De kører to Gemma 4-modeller fra Google til udkast, opslag og automatiseringer, ikke som en ChatGPT til alle. Bureauet har ingen IT-afdeling, så modellerne kører via Ollama på en arbejdsstation på det lokale netværk, og den opdateres og genstartes som en almindelig app. Det rækker til et bureau med et begrænset forbrug, men det er ikke en opsætning, der skal bære et forretningskritisk system.
Skal alle 100 medarbejdere have noget, der minder om ChatGPT, er en licens næsten altid bedre. Skal de største modeller køre lokalt for mange brugere, kræver det en server med Nvidias B200-kort til omkring 2,5 til 3 mio. kr. Det er ikke en besparelse. Det giver kun mening, hvis I hele tiden arbejder med følsomme personoplysninger, fx i en kommune.
Se casenCase: Mediebureau
Faldgruber
Ingen til at drive det. Der kommer nye modeller hele tiden. Qwen er gået fra 3.6 til 3.8 i år, og Qwen 4 er under træning. Hardware og software skal vedligeholdes, og det skal ligge hos jeres IT eller hos et datacenter. Jeg bygger løsningen og sætter modellerne op, men jeg står ikke for driften.
Det forkerte værktøj. Ollama er lavet til at køre en model på én maskine og behandler som udgangspunkt én forespørgsel ad gangen. vLLM er bygget til mange samtidige forespørgsler, og det er det, jeg bruger, når et system skal bære et stort forbrug.
At forvente ChatGPT i fri chat. I afgrænsede automatiseringer er de mellemstore modeller lige så gode som de store tjenester. I fri chat svarer Qwen 3.8 27B til de mindre modeller fra OpenAI og Anthropic. Det er en af grundene til, at jeg sjældent anbefaler lokal AI til chat.
At leje i stedet for at eje. Lejer I grafikkort time for time, betaler I også udbyderens fortjeneste. Besparelsen kommer, når I ejer hardwaren.
Spørgsmål, I bør stille jer selv eller jeres leverandør
- Må de data, AI'en skal arbejde med, forlade vores systemer ifølge vores databehandleraftaler?
- Er det chat til mange medarbejdere eller AI inde i vores systemer?
- Hvor mange tokens bruger vi i dag, og hvor mange bruger vi om et år?
- Kan opgaven løses af en lille model, eller kræver den de største?
- Hvem opdaterer modellerne og passer serveren?
Står I med data, der ikke må forlade huset, så start med at måle tokenforbruget på én automatisering. Så ved I, om regnestykket bærer, før I køber hardware.
Læs mereAI og automatisering
Se det i praksis
Bureau med ~20 medarbejdere
Mediebureau
1system i stedet for fem
Før: CRM, mail, filer, kalender og support lå hver sit sted.
Nu: Ét system til det hele, med AI der kører lokalt.
Spørgsmål og svar
Hvad er digital suverænitet?
Digital suverænitet er kontrol over egne data, digitale tjenester og IT-infrastruktur. For en virksomhed, der bruger AI, handler det om, hvor jeres tekster og dokumenter ender, og hvem der kan få adgang til dem. Kører modellen på jeres egen hardware, forlader data ikke jeres miljø.
Er open source-modeller gode nok til virksomheder?
Ja, oftest. Gemma 4 fra Google og Qwen fra Alibaba er frit tilgængelige, og i afgrænsede automatiseringer som klassificering, routing og udkast leverer de mellemstore modeller på højde med de store tjenester. I fri chat er de svagere end de største modeller.
Hvad koster det at køre AI på egen hardware?
Et grafikkort, der kan køre en model på 27 milliarder parametre, koster i dag omkring 24.000 til 40.000 kr. uden moms. Hertil kommer en server, hvis I ikke har en, som kan koste fra 40.000 til 100.000 kr. afhængigt af, hvad den ellers skal kunne, og IT-tid til drift. Strømmen er en lille post.
Må vi sende kontrakter og kundedata til ChatGPT?
Det afhænger af jeres databehandleraftaler og af, hvad dokumenterne indeholder, og det spørgsmål skal jeres jurist eller DPO svare på. Personoplysninger, som I ikke må videregive, må ikke sendes til en tredjepart. Kontrakter uden personoplysninger kan være lovlige at sende, men indeholder ofte forretningshemmeligheder, som I selv må vurdere.
Hvad er forskellen på Ollama og vLLM?
Begge kan køre open source-modeller på egen hardware. Ollama er lavet til én maskine og behandler som udgangspunkt én forespørgsel ad gangen. vLLM er bygget til mange samtidige forespørgsler og passer bedre, når et system i drift skal bruge modellen.